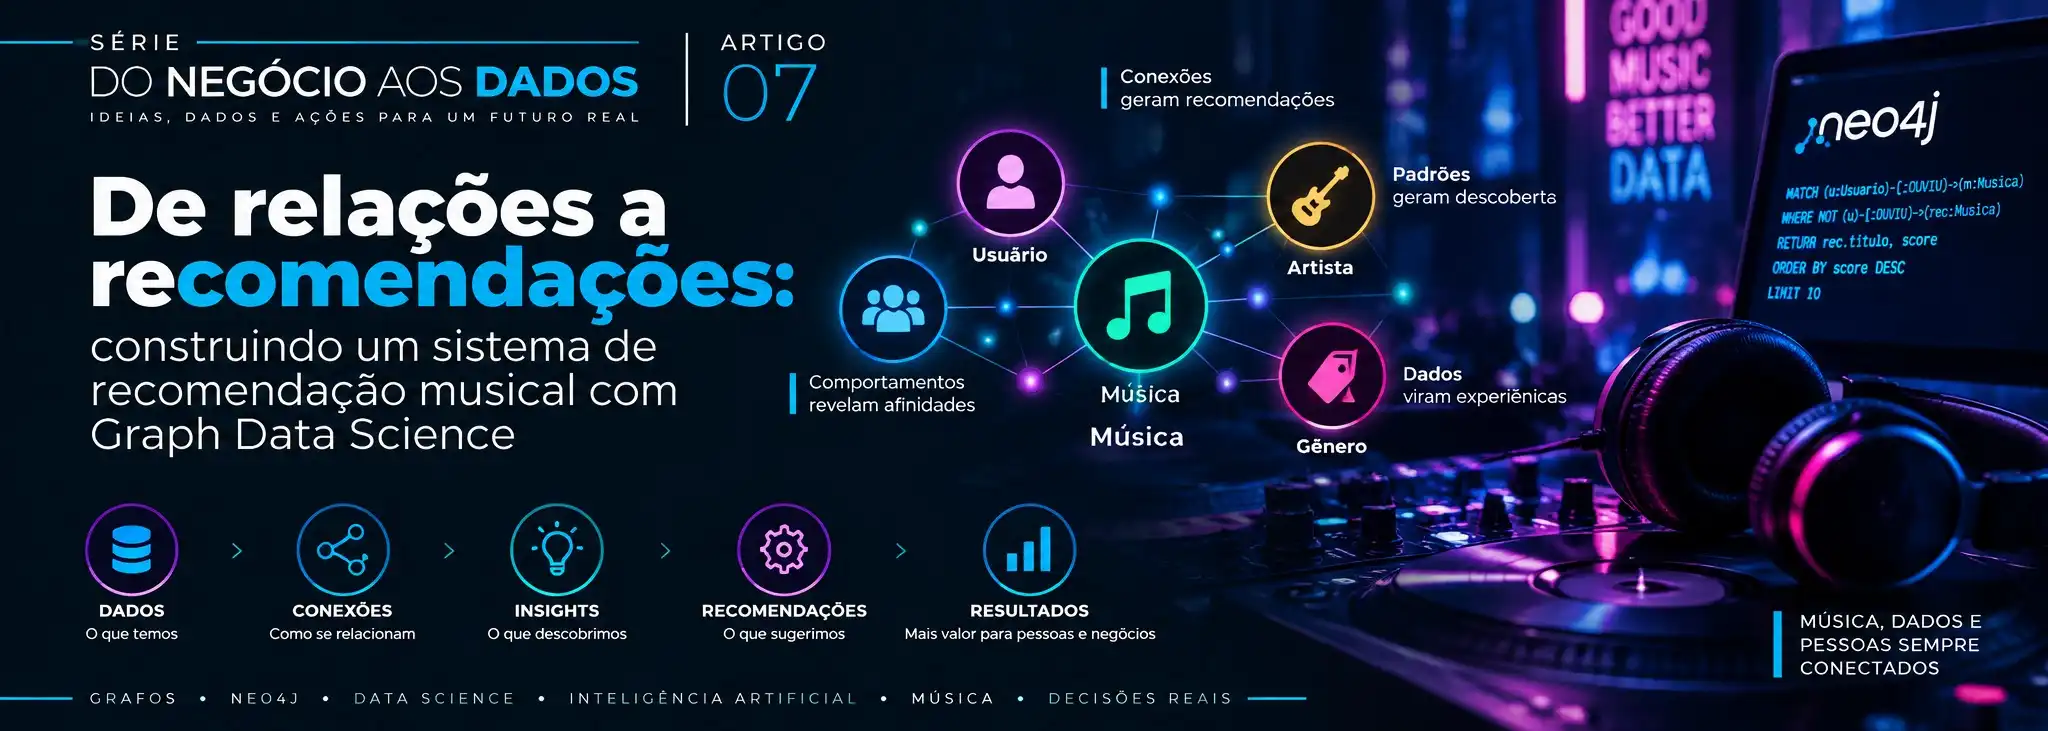
De relações a recomendações: construindo um sistema de recomendação musical com Graph Data Science
- #Machine Learning
- #Python
- #Neo4J
Durante décadas, escolher a próxima música fez parte do meu trabalho como DJ.
Na pista, essa decisão envolve observar pessoas, interpretar reações, reconhecer padrões e relacionar músicas, artistas, gêneros, épocas e contexto.
Décadas depois, estudando Data Science, Neo4j e Graph Data Science, encontrei uma pergunta curiosamente familiar:
Como transformar relações entre usuários, músicas, artistas e gêneros em recomendações?
Foi assim que um exercício técnico deixou de ser apenas um estudo sobre grafos e passou a conectar duas áreas aparentemente distantes da minha trajetória:
música e dados.
🎧 O problema de recomendação
Sistemas de recomendação estão presentes em praticamente todo o ecossistema digital.
Spotify, Netflix, YouTube, marketplaces, e-commerces e redes sociais precisam responder continuamente a perguntas semelhantes:
O que este usuário provavelmente gostaria de consumir em seguida?
Existem diversas estratégias para construir esses sistemas.
Podemos utilizar:
- popularidade;
- regras de negócio;
- características dos itens;
- comportamento dos usuários;
- filtragem colaborativa;
- Machine Learning;
- embeddings;
- grafos.
Neste estudo, a pergunta foi:
E se utilizarmos as próprias relações existentes entre usuários e músicas para encontrar padrões de afinidade?
É exatamente aí que grafos começam a fazer sentido.
🔗 Modelando o domínio como grafo
Antes do algoritmo, precisamos modelar o problema.
Podemos começar com quatro entidades principais:
Usuario
Musica
Artista
Genero
E relacionamentos como:
(Usuario)-[:OUVIU]->(Musica)

(Usuario)-[:CURTIU]->(Musica)

(Musica)-[:INTERPRETADA_POR]->(Artista)

(Musica)-[:PERTENCE_A]->(Genero)

(Usuario)-[:SEGUE]->(Artista)
Visualmente:
           ┌───────────┐
           │  Artista  │
           └─────▲─────┘
                 │
         INTERPRETADA_POR
                 │
┌─────────┐     ┌──┴───────┐
│ Usuario │────►│  Musica   │
└─────────┘     └────┬──────┘
  OUVIU             │
               PERTENCE_A
                    │
              ┌─────▼─────┐
              │  Genero   │
              └───────────┘
Essa modelagem é importante porque sistemas de recomendação são, em essência, problemas fortemente baseados em relações.
🧩 Criando dados com Cypher
Podemos criar um exemplo simplificado:
CREATE (u1:Usuario {nome: 'Usuario A'})
CREATE (u2:Usuario {nome: 'Usuario B'})

CREATE (m1:Musica {titulo: 'Hot Stuff'})
CREATE (m2:Musica {titulo: 'Le Freak'})
CREATE (m3:Musica {titulo: 'We Are Family'})
CREATE (m4:Musica {titulo: 'Disco Inferno'})
Depois criamos as interações:
MATCH
  (u1:Usuario {nome: 'Usuario A'}),
  (u2:Usuario {nome: 'Usuario B'}),
  (m1:Musica {titulo: 'Hot Stuff'}),
  (m2:Musica {titulo: 'Le Freak'}),
  (m3:Musica {titulo: 'We Are Family'}),
  (m4:Musica {titulo: 'Disco Inferno'})

CREATE
  (u1)-[:OUVIU]->(m1),
  (u1)-[:OUVIU]->(m2),
  (u1)-[:OUVIU]->(m3),

  (u2)-[:OUVIU]->(m1),
  (u2)-[:OUVIU]->(m2),
  (u2)-[:OUVIU]->(m4)
Agora temos algo interessante.
Os dois usuários ouviram:
Hot Stuff
Le Freak
Mas apenas o Usuário B ouviu:
Disco Inferno
Isso cria uma possibilidade de recomendação.
🔎 Encontrando usuários com interesses em comum
Com Cypher, podemos procurar usuários conectados às mesmas músicas:
MATCH
  (u1:Usuario)-[:OUVIU]->(m:Musica)<-[:OUVIU]-(u2:Usuario)

WHERE id(u1) < id(u2)

RETURN
  u1.nome AS usuario1,
  u2.nome AS usuario2,
  count(m) AS musicas_em_comum

ORDER BY musicas_em_comum DESC
A estrutura procurada é:
Usuario A → Musica ← Usuario B
Quanto maior a quantidade de músicas compartilhadas, maior pode ser a evidência de afinidade entre os usuários.
Mas isso ainda é apenas uma heurística.
Precisamos transformar essa ideia em uma medida mais estruturada de similaridade.
🧠 Similaridade entre usuários
Imagine:
Usuario A = {A, B, C, D}

Usuario B = {A, B, C, E}
Eles compartilham:
{A, B, C}
Uma possibilidade é utilizar Jaccard Similarity.
A ideia é:
J(A,B) =
itens em comum
──────────────
total de itens distintos
Formalmente:
J(A,B) = |A ∩ B| / |A ∪ B|
No nosso exemplo:
A ∩ B = {A, B, C}

A ∪ B = {A, B, C, D, E}
Portanto:
J(A,B) = 3 / 5 = 0,60
Quanto mais próximo de 1, maior a sobreposição entre os conjuntos.
Essa é apenas uma das possíveis medidas. O algoritmo adequado depende da representação dos dados e do objetivo do sistema.
🕸️ Entrando no Graph Data Science
Com Neo4j Graph Data Science (GDS), podemos trabalhar sobre uma projeção do grafo para executar algoritmos analíticos.
Conceitualmente, o processo passa a ter duas camadas:
Neo4j Database
    ↓
Graph Projection
    ↓
GDS Algorithm
    ↓
Similarity Score
    ↓
Recommendation Candidates
Essa separação é importante.
O grafo armazenado no banco representa o domínio.
O grafo projetado para GDS representa a estrutura sobre a qual queremos executar determinado algoritmo.
📐 Do score à recomendação
Imagine que identificamos:
Usuario A ↔ Usuario B
similaridade = 0,82
Agora podemos perguntar:
Quais músicas o Usuário B ouviu que o Usuário A ainda não ouviu?
Conceitualmente:
Usuario A
  │
  ├── ouviu → Música 1
  ├── ouviu → Música 2
  └── ouviu → Música 3


Usuario B
  │
  ├── ouviu → Música 1
  ├── ouviu → Música 2
  ├── ouviu → Música 3
  └── ouviu → Música 4
Se A e B apresentam alta similaridade, Música 4 passa a ser uma candidata à recomendação para A.
Em Cypher, uma lógica simplificada poderia seguir:
MATCH
  (alvo:Usuario {nome: 'Usuario A'})-[:OUVIU]->(m:Musica)
  <-[:OUVIU]-(similar:Usuario)

MATCH
  (similar)-[:OUVIU]->(recomendacao:Musica)

WHERE NOT (alvo)-[:OUVIU]->(recomendacao)

RETURN
  recomendacao.titulo,
  count(*) AS score

ORDER BY score DESC
LIMIT 10
Esse exemplo é deliberadamente simples, mas demonstra uma ideia fundamental:
Uma recomendação pode emergir da estrutura das conexões.
🎯 Mas popularidade não é personalização
Existe uma armadilha importante.
Se simplesmente contarmos quantas vezes uma música aparece entre usuários relacionados, podemos acabar recomendando sempre os itens mais populares.
Isso não significa necessariamente que construímos um bom sistema personalizado.
Precisamos considerar outros fatores:
similaridade do usuário;
peso das interações;
recência;
frequência;
preferências por gênero;
artistas já consumidos;
diversidade das recomendações.
Uma interação também não precisa ter sempre o mesmo peso.
Por exemplo:
OUVIU        = 1
CURTIU       = 3
SALVOU       = 4
ADICIONOU    = 5
Agora o grafo passa a carregar não apenas relações, mas também intensidade de preferência.
⚖️ Relevância x descoberta
Outro problema interessante em sistemas de recomendação é encontrar equilíbrio entre:
relevância e descoberta.
Se recomendarmos apenas músicas extremamente semelhantes às que o usuário já conhece, podemos criar uma espécie de bolha.
O sistema torna-se previsível.
Por outro lado, recomendações muito distantes do comportamento conhecido podem perder relevância.
Um bom recomendador precisa administrar algo próximo de:
Familiaridade ←────────────→ Descoberta
Esse desafio existe também fora da música.
Ele aparece em:
produtos, filmes, notícias, cursos, vagas, conteúdos e serviços.
📊 Como avaliar um recomendador?
Construir recomendações não significa que elas são boas.
Precisamos avaliar.
Duas métricas conhecidas são:
Precision@K
Entre os K itens recomendados, quantos eram relevantes?
Precision@K =
itens relevantes recomendados
─────────────────────────────
K
Recall@K
Entre todos os itens relevantes para aquele usuário, quantos apareceram nas recomendações?
Recall@K =
itens relevantes recomendados
─────────────────────────────
total de itens relevantes
Mas métricas offline são apenas uma parte da história.
Em produção, também poderíamos observar:
CTR
tempo de consumo
skip rate
likes
saves
conversão
retenção
engajamento
Porque um sistema de recomendação precisa produzir comportamento útil, não apenas bons scores matemáticos.
🔄 O feedback fecha o ciclo
Suponha que recomendamos uma música.
O usuário:
ouve
↓
curte
↓
adiciona à playlist
↓
segue o artista
Essas ações criam novas relações.
Então:
Dados → Relações → Similaridade → Recomendação → Interação → Novos dados
E o sistema pode evoluir.
Essa é uma das características mais interessantes desse tipo de arquitetura.
A recomendação não precisa ser o final do processo.
Ela pode gerar o dado que alimentará a próxima recomendação.
🤖 Onde entra Machine Learning?
Um sistema real pode combinar diferentes técnicas.
Por exemplo:
Graph Data Science
      +
Collaborative Filtering
      +
Content-Based Filtering
      +
Embeddings
      +
Machine Learning
      +
Regras de negócio
E, dependendo do produto, podemos adicionar IA Generativa em outras camadas da experiência.
O ponto importante é:
Não existe obrigação de resolver tudo com uma única tecnologia.
Arquiteturas de dados e IA podem combinar técnicas diferentes, cada uma resolvendo a parte do problema para a qual é mais adequada.
🎚️ O que Data Science encontrou na cabine de DJ
Foi nesse ponto que o projeto deixou de ser apenas técnico para mim.
Durante décadas como DJ, minha lógica sempre envolveu algo parecido com:
Observar
↓
Interpretar
↓
Reconhecer padrões
↓
Relacionar repertório
↓
Escolher
↓
Observar novamente
Em um sistema orientado por dados:
Coletar
↓
Modelar
↓
Encontrar padrões
↓
Calcular similaridade
↓
Recomendar
↓
Coletar feedback
São processos diferentes.
Um DJ trabalha com elementos humanos, culturais e contextuais que dificilmente são totalmente representados por um algoritmo.
Mas existe uma interseção conceitual:
usar padrões observados anteriormente para reduzir a incerteza sobre o que pode funcionar em seguida.
Para mim, essa foi uma das conexões mais interessantes de todo o projeto.
🚀 De relações a recomendações
O projeto começou com uma pergunta:
Como utilizar relações para gerar recomendações?
E terminou reforçando uma ideia maior.
Quando modelamos dados como uma rede, começamos a enxergar:
Entidades
 ↓
Relações
 ↓
Padrões
 ↓
Similaridade
 ↓
Recomendações
 ↓
Interações
 ↓
Novos dados
O valor não está apenas no algoritmo.
Está no sistema inteiro.
🧠 O principal aprendizado
Se eu tivesse que resumir este projeto em uma frase, seria:
Sistemas de recomendação não tentam simplesmente encontrar coisas parecidas. Eles tentam transformar padrões de comportamento em possibilidades relevantes.
Neo4j e Graph Data Science me deram uma maneira diferente de explorar esse problema.
E, curiosamente, acabaram conectando duas partes da minha trajetória que pareciam muito distantes:
a cabine de DJ e a Data Science.
Talvez transição profissional também tenha algo de grafo.
Novos conhecimentos não precisam substituir os anteriores.
Podemos criar novas relações entre eles.
E dessas conexões podem surgir possibilidades que antes não enxergávamos.
Negócio + Dados + IA = Decisões melhores, mais rápidas e com maior impacto.
💬 E você?
Se tivesse que construir um sistema de recomendação hoje, começaria pelas características dos itens, pelo comportamento dos usuários ou pelas relações entre eles?
#Neo4j #GraphDataScience #RecommendationSystems #DataScience #Cypher #MachineLearning #Python #Grafos #InteligenciaArtificial #Dados