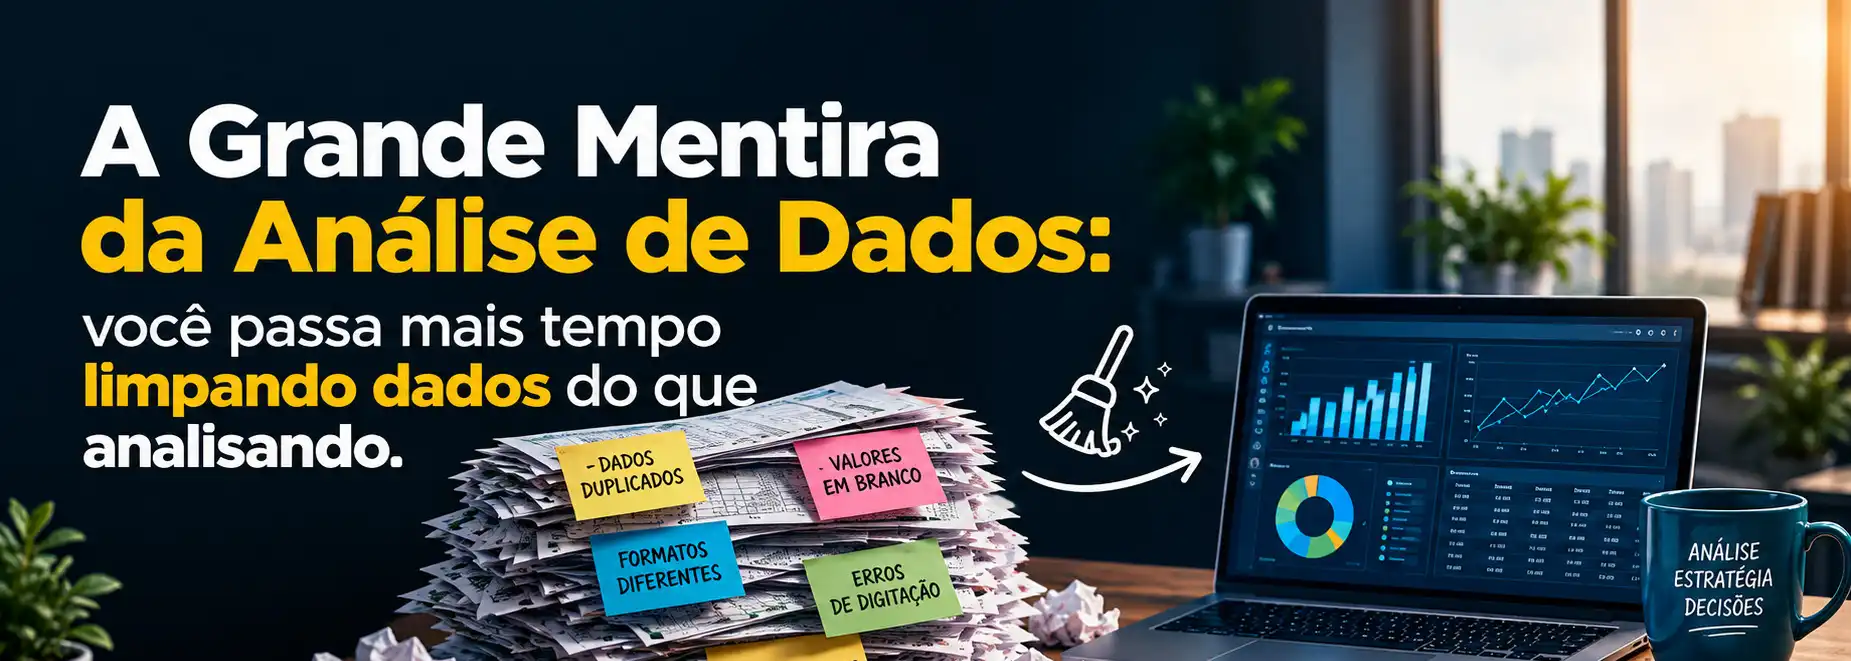
A Grande Mentira da Análise de Dados
Você imagina que trabalhar com dados é criar dashboards e descobrir insights. Até encontrar uma planilha com duplicidades, valores nulos e informações inconsistentes.
Na prática, antes de analisar dados, você precisa torná-los confiáveis.
O problema na prática
Imagine esta tabela:
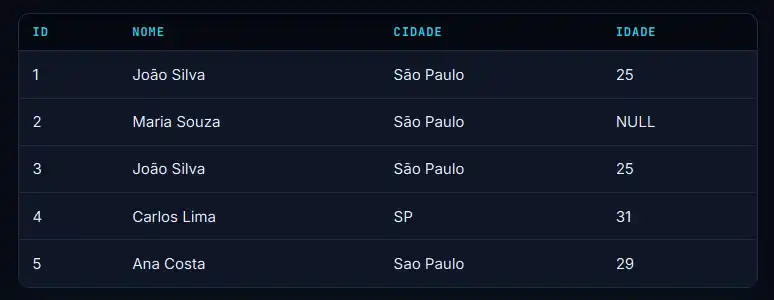
Temos um registro duplicado, uma idade ausente e três formas de representar a mesma cidade.
Limpando com SQL
Identificar duplicados:
SELECT nome, cidade, idade, COUNT(*) AS quantidade
FROM clientes
GROUP BY nome, cidade, idade
HAVING COUNT(*) > 1;
Encontrar valores ausentes:
SELECT *
FROM clientes
WHERE idade IS NULL;
Padronizar cidades:
SELECT CASE
WHEN cidade IN ('SP', 'Sao Paulo') THEN 'São Paulo'
ELSE cidade
END AS cidade_padronizada
FROM clientes;
O tratamento dos valores nulos depende da regra de negócio. E, para remover duplicidades, é essencial escolher as colunas corretas: SELECT DISTINCT * não resolveria o caso se o ID fosse diferente em cada linha.
E no Power BI?
No Power Query, você pode usar Remover Duplicatas, Substituir Valores e as ferramentas de formatação de texto para corrigir esses problemas antes de criar os visuais.
Por que isso importa?
Um relatório pode mostrar São Paulo (50), SP (20) e Sao Paulo (15). Após a padronização, temos 85 clientes em uma única categoria.
Pior: uma tabela importada duas vezes pode simular um crescimento de vendas que nunca existiu.
É o princípio garbage in, garbage out: dados ruins geram resultados ruins.
Conclusão
Dominar SQL e Power BI é importante, mas saber questionar e validar os dados é essencial.
Antes de criar um dashboard, pergunte: existem duplicidades? Há valores ausentes? Os resultados fazem sentido?
Dashboards impressionam. Dados confiáveis transformam decisões.
E você, qual foi a pior sujeira que já encontrou em uma base de dados?