A Engenharia da Qualidade aplicada à Análise de Dados
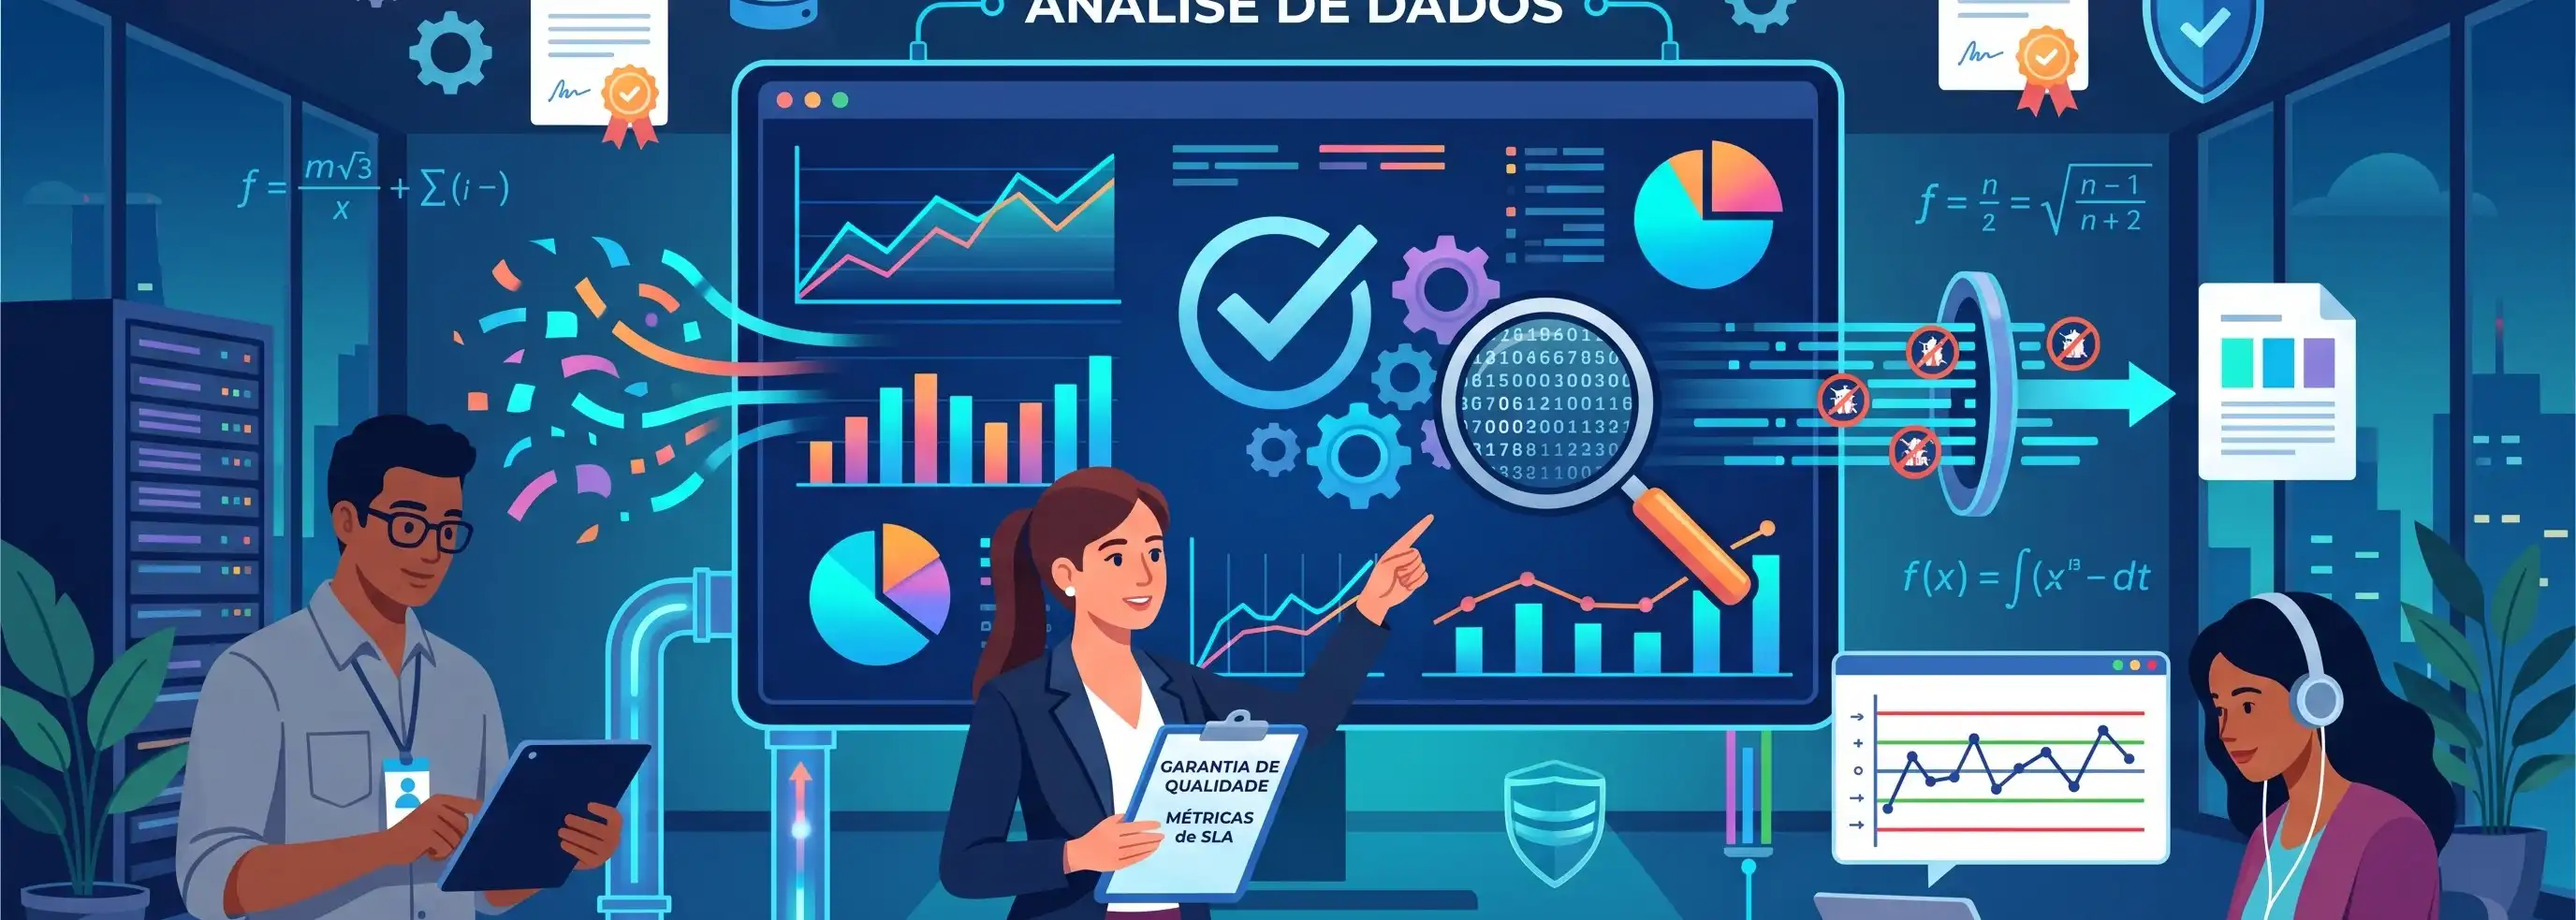
O objetivo deixa de ser apenas medir a qualidade após o fato, passando a prever falhas, automatizar a garantia da qualidade e otimizar processos continuamente em tempo real.
1. Fundamentos da Engenharia da Qualidade Orientada a Dados
Historicamente, a Engenharia da Qualidade baseava-se em amostragens estatísticas manuais (como o Controle Estatístico de Processos - CEP tradicional). Com o avanço da análise de dados, a área evoluiu para dois grandes pilares de atuação:
- Qualidade para Dados (Data Quality Engineering): Garantir que os dados coletados por pipelines, sensores e sistemas sejam confiáveis, completos, padronizados e sem anomalias.
- Dados para a Qualidade (Quality Analytics): Utilizar dados históricos e em tempo real para monitorar a qualidade de produtos, serviços e processos operacionais.
2. As Duas Frentes de Aplicação
Frente A: Qualidade Aplicada à Infraestrutura e Pipelines de Dados
Antes de confiar em dashboards ou modelos preditivos, o engenheiro da qualidade valida a integridade da base de dados.
- Validação de Schemas e Contratos: Garantir que as alterações em tabelas de origem não quebrem fluxos downstream.
- Teste de Integridade e Completude: Verificação automatizada de valores nulos, registros duplicados e valores fora de limites operacionais (outliers).
- Observabilidade de Dados: Monitoramento da latência, volume e consistência ao longo de pipelines ETL/ELT.
Frente B: Análise de Dados Aplicada à Qualidade do Produto/Processo
Aplicações analíticas para melhorar produtos industriais, serviços digitais e softwares:
- Controle Estatístico de Processos Avançado (CEP 4.0): Substituição de cartas de controle analógicas por gráficos em tempo real alimentados por IoT.
- Manutenção Preditiva e Detecção de Anomalias: Algoritmos que identificam desvios microscópicos antes que gerem refugos ou falhas críticas.
- Análise da Causa Raiz (RCA Preditiva): Modelos de regressão ou árvores de decisão para identificar variáveis ambientais ou operacionais que causam defeitos.
3. Metodologias e Frameworks Integrados
Metodologia TradicionalEvolução com Análise de DadosDMAIC (Six Sigma)Substituição de amostragens manuais pela análise da população completa de dados (Big Data).FMEA (Análise de Modos de Falha)FMEA Preditivo: Algoritmos calculam o RPN (Número de Prioridade de Risco) dinamicamente com base em histórico de telemetria.DOE (Design de Experimentos)Experimentos digitais automatizados e Testes A/B multivariados contínuos.Análise de Custos da Qualidade (COQ)Modelagem de custos de prevenção, avaliação e falhas com regressão estatística.
4. Stack Tecnológico do Engenheiro da Qualidade
- Linguagens & Manipulação de Dados: Python (
pandas,numpy,scipy), SQL. - Estatística & Machine Learning:
statsmodels,scikit-learn(para modelos de regressão, classificação de defeitos e agrupamento). - Visualização & BI: Power BI, Tableau, Grafana (dashboards em tempo real para fábrica ou software).
- Qualidade de Dados (Frameworks): Great Expectations, dbt (data build tool), Soda Core.
- Orquestração e Monitoramento: Apache Airflow, MLflow.
5. Exemplo Prático: Detecção de Anomalias no Processo em Python
Abaixo está uma demonstração simples de como um Engenheiro da Qualidade utiliza estatística em Python para identificar desvios operacionais (pontos fora dos limites de controle 3 sigma):
import numpy as np
import pandas as pd


# 1. Simulação de dados de produção (ex: diâmetro de uma peça em mm)
np.random.seed(42)
dados_normais = np.random.normal(loc=10.0, scale=0.2, size=100)
anomalias = [10.8, 9.1, 10.9] # Falhas de processo
medicoes = np.concatenate([dados_normais, anomalias])


df = pd.DataFrame(medicoes, columns=['medida'])


# 2. Cálculo dos limites de controle estatístico (3-Sigma)
media = df['medida'].mean()
desvio_padrao = df['medida'].std()


limite_superior (LIC) = media + 3 * desvio_padrao
limite_inferior (LSC) = media - 3 * desvio_padrao


# 3. Identificação automática de não conformidades
df['fora_de_controle'] = (df['medida'] > limite_superior) | (df['medida'] < limite_inferior)


defeitos = df[df['fora_de_controle']]
print(f"Número de não conformidades detectadas: {len(defeitos)}")
6. Desafios de Implementação
- Qualidade na Origem (Garbage in, Garbage out): Sem pipelines bem construídos, a análise de dados gera diagnósticos falsos.
- Silos Organizacionais: Integração necessária entre equipes de TI/Dados, Operações/Engenharia e Gestão da Qualidade.
- Resistência à Mudança: Transição da tomada de decisão baseada na "intuição de especialistas" para decisões 100% orientadas a dados (Data-Driven).